훈련 데이터가 300시간에서 30,000시간으로 확장된다면, 로봇 모델은 대규모 언어 모델처럼 데이터가 증가함에 따라 계속해서 새로운 기능을 잠금 해제할 수 있습니까?
AGIBOT의 새로 출시된 기본 세계인 WAM(World Action Model) GE-Act 2.0은 처음으로 이 질문에 체계적으로 답합니다. 기성 비디오 생성 모델을 사용하는 주류 경로와 달리 시각적 표현, 미래 생성 및 동작 예측과 같은 핵심 구성 요소를 포함하는 GE-Act 2.0의 모든 모델 매개 변수는 무작위 초기화에서 시작하여 구현된 작업 데이터에 대해 처음부터 훈련됩니다. 훈련이 완료된 후 모델은 평가 작업에 대한 미세 조정이나 시연을 수행하지 않습니다. 100가지 원자 태스크, 20가지 유형의 스킬, 2개의 로봇 몸체를 다루며 낯선 장면과 물체에 대한 낯선 환경에서의 언어 지시 따르기, 다중 기술 조작, 일반화 등 실제 기계 제로샷 테스트를 직접 수용합니다.
결과는 다음과 같습니다. 데이터 규모가 100배로 확장됨에 따라 모델은 더욱 안정적인 고유 기술을 갖게 될 뿐만 아니라 수건 접기, 종이 중첩 등 이전에는 전혀 불가능했던 새로운 작업을 점차적으로 잠금 해제합니다.컵핑, 펜캡 뽑기 및 삽입, 꽃꽂이 등 미세한 움직임을 위해 네이티브 월드 액션 모델의 스케일링 경로가 처음으로 체계적으로 검증되었습니다.
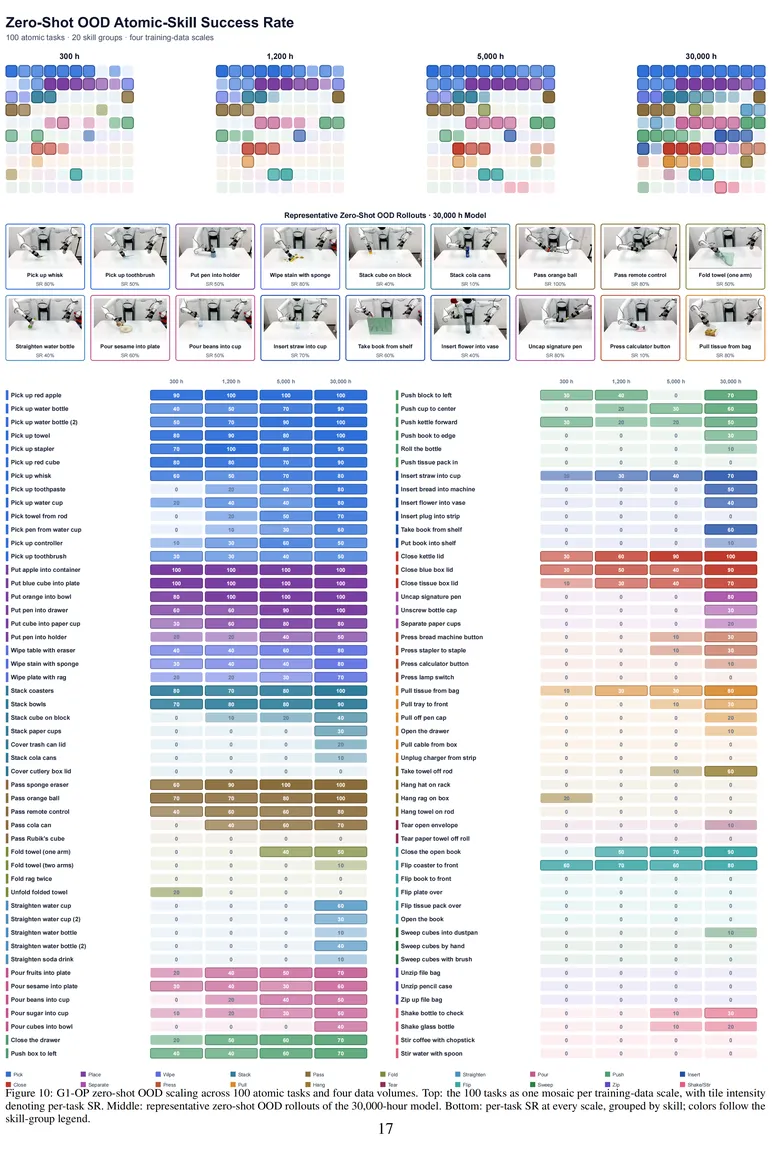
그림의 각 작업은 4가지 수준의 데이터 교육(300시간/1200시간/5000시간/30000시간)을 받습니다. 훈련 데이터가 계속 확장됨에 따라 스킬 적용 범위와 작업 성공률이 동시에 확장되어 기본 세계 행동 모델 사전 훈련 및 확장 경로를 검증합니다.
프로젝트 홈페이지 및 논문:
https://ge-act-v2.github.io/
01/
Zero-shot을 사용하여 사전 훈련 테스트
100x 데이터로 스케일링 확인
평가 과제에 대한 추가 교육을 받으면 성적이 향상될 수 있지만, 능력이 일반 사전 교육에서 나오는지 아니면 '시험 전 특별 교육'에서 나오는지 알 수 없습니다. 따라서 GE-Act 2.0은 실제 기계의 제로 샘플 성능을 표준으로 삼습니다. 즉, 미세 조정, 시연, 모델 교체가 없으며 테스트의 장면, 배경, 조명 및 개체 인스턴스가 교육에 포함되지 않습니다. 동일한 훈련 공식에 따라 마지막 단계에서는 각각 300/1,200/5,000/30,000시간의 4가지 데이터 수준을 사용합니다. 세 가지 스케일링 단서가 명확하게 표시됩니다.
l 스킬 "각 프레임 조명": 성공률이 0이 아닌 작업 수가 G1-OP 로봇에서는 39에서 76으로, G2-90D 로봇에서는 24에서 72로 증가했습니다. 수건 접기, 종이컵 중첩, 펜 뚜껑 뽑기 및 삽입, 꽃꽂이 등과 같은 미세한 작업은 소규모 데이터로 학습된 모델에서는 이해할 수 없습니다. 데이터가 30,000시간에 도달하면 중요한 능력 통찰력이 나타납니다.
l 임무 성공률이 계속 증가합니다:G1-OP 로봇의 전체 성공률은 17.1%에서 44.1%로 증가했고, G2-90D 로봇은 13.4%에서 31.1%로 증가했으며, 5,000~30,000시간 후에도 뚜렷한 포화가 없었습니다.
l "풍부한 온톨로지"는 "희소한 온톨로지"를 유발합니다.G1-OP 로봇은 훈련 데이터의 50% 이상을 기여했으며 G2-90D 로봇은 2% 미만을 차지했습니다. 그러나 공유 데이터가 확대되면서 후자는 여전히 17.7%포인트 증가해 실제로 신체 간 능력 이전이 이뤄지고 있음을 보여준다.
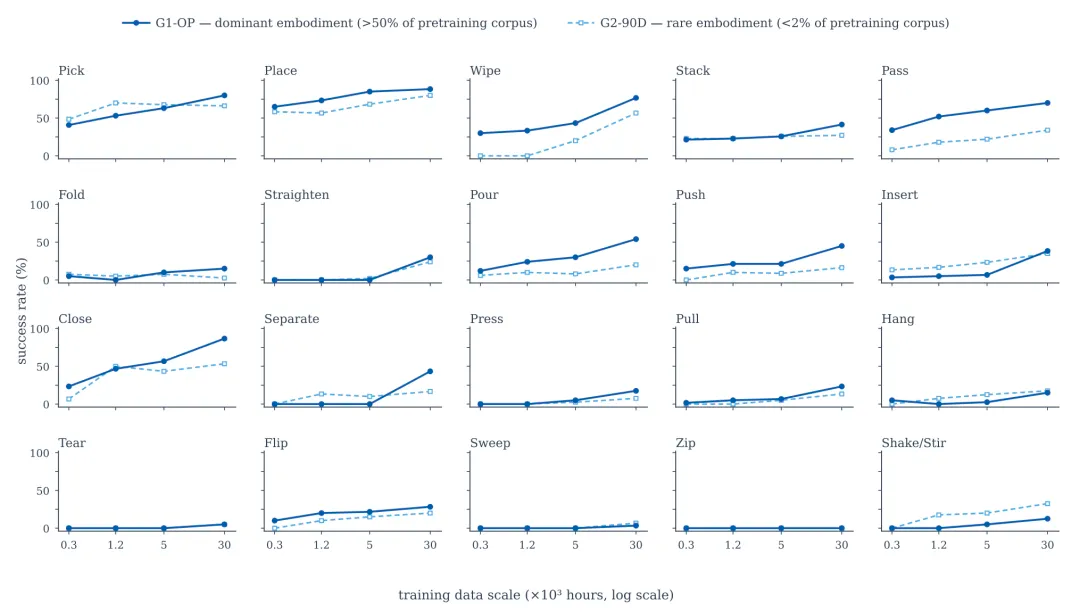
훈련 데이터의 확장으로 두 로봇의 대부분의 기술이 지속적으로 향상되고 있으며, 데이터의 2% 미만을 차지하는 G2-90D도 상당한 성장을 보였습니다.
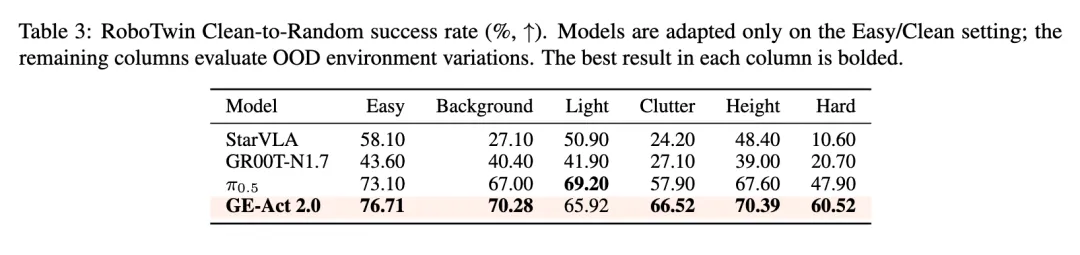
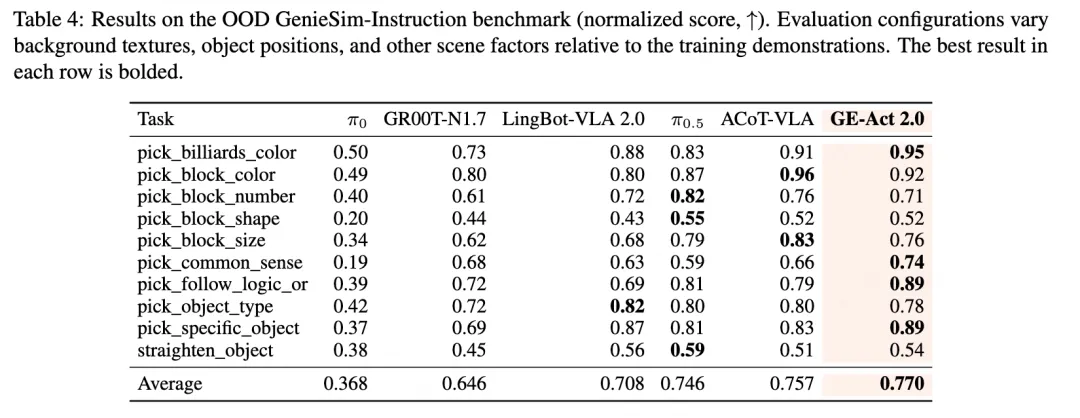
보완적으로 미세 조정된 GE-Act 2.0은 RoboTwin 낯선 환경 테스트에서 성공률 60.52%, GenieSim 명령 준수 테스트에서 0.770점을 달성하여 두 가지 모두 π0.5, GR00T N1.7 및 비교에 참여한 다른 모델을 능가했습니다.
02/
기본 월드 액션 모델을 사전 훈련하는 방법
GE-Act 2.0은 방법론을 제공합니다.
전통적인 행동 모델은 "눈에 보이는 대로 행동하세요"; 세계 행동 모델은 한 단계 더 나아갑니다. 먼저 "이 일을 계속하면 세상은 어떻게 보일 것인가"를 예측한 다음 행동을 결정합니다. 그러나 대부분의 세계 액션 모델은 기존 비디오 생성 모델에서 시작하여 액션 모델로 연결됩니다. 이 방법은 구현된 데이터로부터 세계 예측 및 행동 능력이 어떻게 얻어지는지 파악하기 어렵게 만듭니다.GE-Act 2.0은 구현된 작업을 위해 전체 아키텍처를 재설계하고 처음부터 사전 훈련을 위한 완전한 방법론을 제공합니다.
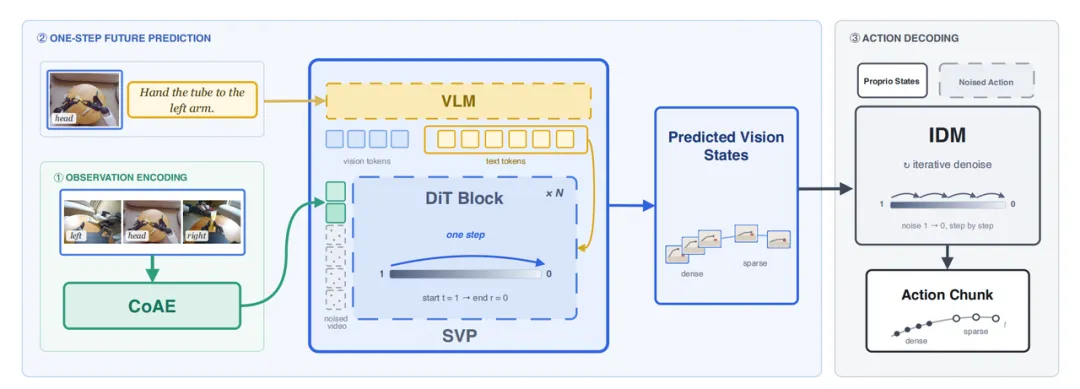
GE-Act 2.0 아키텍처
01 기본 효율적인 표현: 하나의 프레임이 24개의 토큰으로 압축됩니다.
로봇은 물체와 움직임을 명확하게 볼 수 있을 뿐만 아니라 계산 비용도 제어해야 합니다. GE-Act 2.0은 의미, 모션 및 로컬 구조를 유지하면서 256×384 프레임을 DINOv3의 16분의 1에 불과한 24개의 시각적 토큰으로 압축하는 보다 효율적인 시각적 인코더 CoAE를 설계합니다. 압축 후 역추력의 정확도는 DINOv3 및 V-JEPA 2.1과 같은 고정보 표현의 정확도에 가깝습니다. 로봇 작동 데이터 4,000개에 대한 제어 테스트에서 명령-그림 일치 정확도는 97.95%에 달했으며 이는 5개 제어 표현 중 가장 높습니다.
02 네이티브 비주얼 플래너: "상상력"과 "행동"을 함께 최적화
세계 모델은 미래 예측을 담당하고, 역동역학 모델(IDM)은 행동 생성을 담당합니다. 전통적인 방법은 미래를 생성하기 위해 여러 차례의 계산이 필요하며 계산 및 메모리 사용량이 매우 높습니다. 두 모델을 함께 훈련하는 것은 어렵고 추론 속도도 느려집니다. GE-Act 2.0은 원스텝 시각적 계획을 사용하여 한 번에 완전한 미래를 생성하고 작업 오류를 세계 모델에 직접 피드백할 수 있도록 합니다. 효율적인 시각적 표현과 결합된 이 모델은 RTX 5090 그래픽 카드에서 일련의 연속 작업을 생성하는 데 단 104밀리초밖에 걸리지 않습니다. 이는 대부분의 기존 WAM보다 훨씬 뛰어납니다.
03 합동 훈련 계획: KASO 균열 "예측과 행동 불일치"
동일한 작업을 수행하는 데는 여러 가지 올바른 방법이 있는 경우가 많습니다. 모델은 "왼손으로 잡는 것"을 상상하지만 데이터는 "오른손"을 기록합니다. 각각은 합리적이지만 함께 사용하면 오류 신호입니다. GE-Act 2.0은 이 문제를 해결하기 위해 KASO(Knowledge Alignment Selective Optimization) 방법을 사용합니다. 즉, 한 번에 여러 개의 가능한 미래를 생성하고 실제 행동과 가장 일치하는 결과만 선택하여 훈련에 참여합니다. 낯선 장면의 분포 외(OOD) 평가에서 로봇이 올바른 지시 대상을 선택하는 비율은 기준선에 비해 7.5%포인트 증가했고, 최종 파악 성공률은 10%포인트 증가했다.
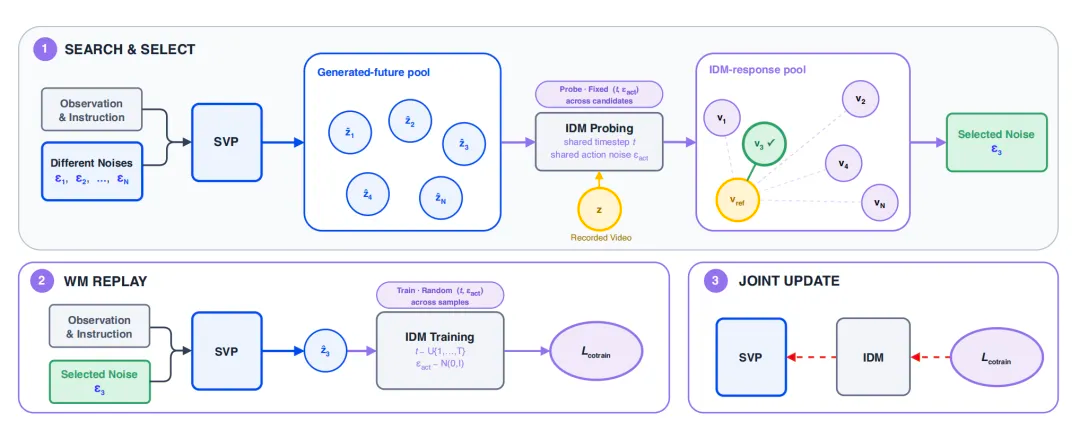
KASO는 여러 예측된 미래에서 실제 행동과 가장 일치하는 결과를 선택한 다음 이를 공동 훈련에 사용하여 미래 예측과 행동 감독 간의 불일치를 방지합니다.
03/
“모든 데이터를 먹는” 아키텍처 세트
원격 작업, 본체 없음, 롤아웃 및 오류 데이터가 모두 제자리에 있습니다.
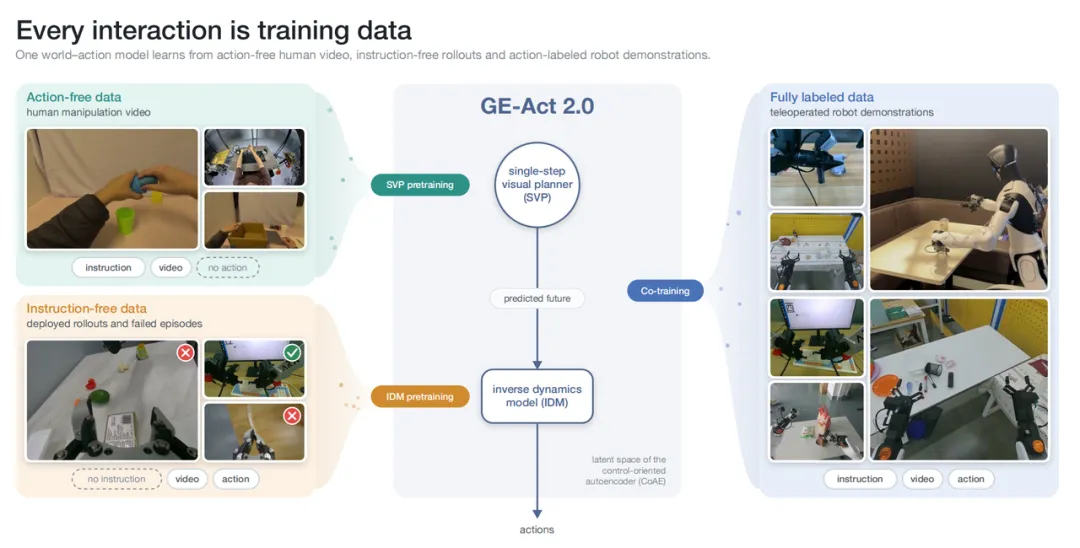
로봇 훈련 및 배포 중에 생성된 데이터는 다양한 형태로 제공됩니다. 전통적인 모방 학습은 완전한 "지시-그림-행동" 쌍에 의존하므로 많은 양의 데이터가 낭비됩니다. GE-Act 2.0에서 제안된 데이터 아키텍처를 통해 각 유형의 데이터가 적절한 학습 작업을 수행할 수 있습니다.
l 세계 모델을 사전 훈련하고 환경이 어떻게 변화하는지 학습하기 위한 39,000시간의 "명령 비디오" 데이터 - 3,000시간의 온톨로지 없는 데이터(액션 주석이 없는 1인칭 관점 및 인간 작동 비디오)를 포함합니다.
l 32,000시간의 로봇 궤적 사전 훈련 역동역학 모델(IDM)을 통해 "그림이 이렇게 변했을 때 로봇이 무엇을 했는지" 학습합니다. 여기에는 2,000시간의 실패한 작업과 실제 장면 배포 롤아웃 데이터가 포함되며 성공 레이블이 필요하지 않습니다.
l 3 1만 시간의 "명령-영상-행동" 전체 데이터가 두 능력을 연결하는 합동 훈련에 사용됩니다.
역동역학 모델의 도움으로 지침이나 성공 레이블이 없고 심지어 실패한 궤적도 작업 감독 신호를 복원할 수 있습니다. 실패 데이터도 교육 자산이 될 수 있습니다.
단계 기반 사전 훈련
GE-Act2.0은 기본 세계 행동 모델의 확장 가능한 사전 훈련 경로를 검증하며 "세계 예측"에서 "세계 중심 행동"으로의 핵심 단계이기도 합니다. AGIBOT GE 월드 모델 시스템에서 GE-Sim은 전략 평가 및 환경 구축을 지향하고 GE-Act는 미래 예측을 실제 로봇 작동 능력으로 변환합니다. 더 많은 유형의 구체화된 데이터가 균일하게 활용되고 제로 샘플 기능이 데이터 규모에 따라 계속 증가함에 따라 구체화된 기본 모델의 확장 경로가 더욱 명확해지고 있습니다.