최근 구체화된 전체 모드 이해의 권위 있는 목록 DailyOmni의 최신 평가 결과가 발표되었습니다. Wisdom이 자체 개발한 구현형 네이티브 풀모달 대형 모델 WITA-Omni Preview는 최고의 오디오 및 비디오 공동 이해 및 시간적 추론 기능을 갖추고 종합 점수 85.21점으로 1위에 올랐으며, Qianwen, Gemini, Doubao, NVIDIA 등 국내외 주요 모델을 제치고 8개 하위 지표 중 6개 항목에서 1위를 차지했습니다.
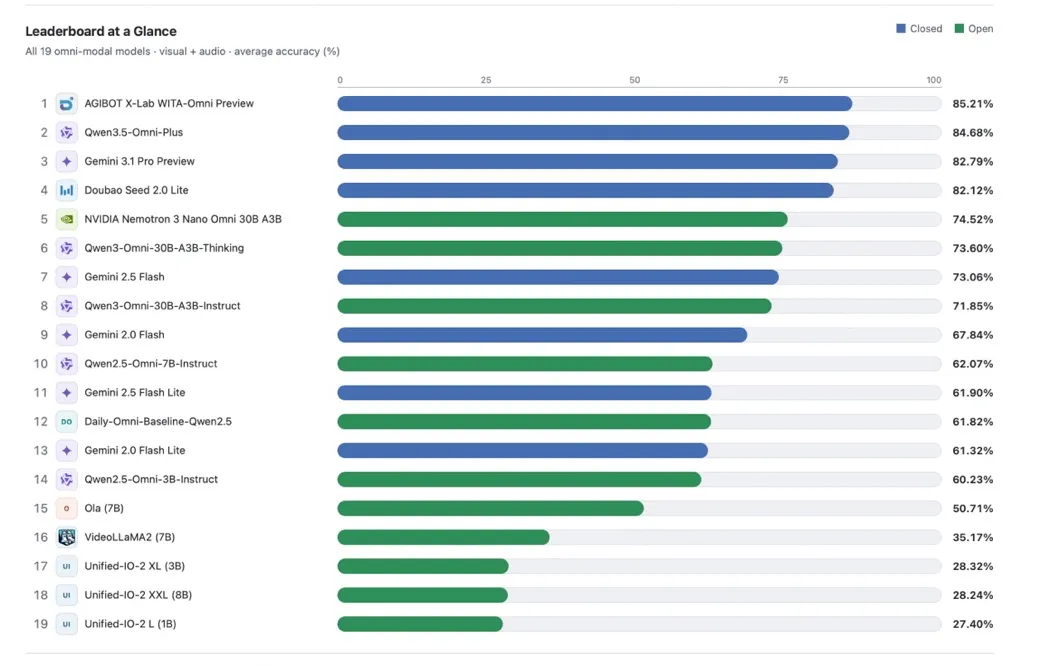
DailyOmni 최신 평가 결과
DailyOmni는 오디오 및 비디오 타이밍 정렬과 교차 모달 공동 추론 기능을 테스트하기 위해 업계에서 인정받는 권위 있는 타사 목록입니다. 그래픽, 텍스트, 짧은 비디오에 대한 기존의 평가 작업과 달리 이 목록에서는 실제 개방형 환경의 오디오 및 비디오 자료를 다수 사용합니다. 핵심 테스트는 시각적 그림과 환경적 오디오 정보를 통합하고, 소리와 그림 간의 대응 관계, 이벤트 순서 및 교차 모드 의미 체계를 정확하게 식별하는 모델의 포괄적인 능력입니다. 이는 휴머노이드 로봇이 실제 물리적 공간에서 인간-컴퓨터 상호 작용을 수행하는 데 필요한 핵심 인식 기능과 매우 일치합니다.
01/
왜 자연스러운가요?WITA-Omni는 임바디드 AI를 위한 상호 작용 아키텍처를 구축하기 위해 행위자에게 고전적인 Thinker-Talker 패러다임을 도입합니다.
휴머노이드 로봇의 대화형 기능과 관련하여 대부분의 이전 풀모달 모델은 온라인 디지털 콘텐츠 상호작용에 적응하는 것을 우선시했습니다. 그러나 로봇은 끊임없이 변화하는 물리적 공간 속에 있다. 그들은 동시에 "그림을 보고 소리를 들을" 필요가 있을 뿐만 아니라 실시간으로 소리의 주제, 사건의 순서를 판단하고 대화형 개체를 식별하고 올바른 응답 시간을 찾아야 합니다. 전통적인 모듈형 로봇 솔루션은 이러한 유형의 시간적 결합의 복잡한 추론 작업을 완료하기 어렵고, 이는 오랫동안 인간-컴퓨터 상호 작용을 엄격하게 분리하는 데 주요 병목 현상이었습니다.
입체 지능형 로봇의 경우 '이해'와 '응답'은 별개의 두 단계가 아니라 계속해서 발생하는 물리적 과정입니다. 로봇은 언어를 정리하고 동작과 표정을 일치시키면서 환경을 관찰하고 소리를 수신해야 합니다. 멀티플레이어, 개방형, 끊임없이 변화하는 실제 환경에서 응답 여부, 응답 시기, 누구와 상호 작용할지에 대한 추가 판단을 내려야 합니다.
WITA-Omni는 상호 작용을 재정의합니다.
WITA-Omni 리더십의 핵심은 단순히 채팅 모델을 로봇에 "설치"하는 것이 아니라 물리적 움직임과 표정을 음성과 평행한 1단계 출력으로 업그레이드하고 기본 엔드 투 엔드 모델을 사용하여 인식, 의사 결정 및 표현을 균일하게 구동하고 Thinker-Talker-Actor 아키텍처를 더욱 확장하여 Thinker-Talker 패러다임의 구현된 출력을 제공한다는 것입니다.
사상가 은 텍스트, 이미지, 오디오, 오디오 및 비디오를 각각의 인코더와 경량 프로젝션 레이어를 통해 통합 표현 공간에 매핑하는 다중 모드 추론의 핵심으로, 교차 모드 공동 추론과 높은 수준의 대화형 의사 결정을 허용합니다.
화자 와 함께 Thinker의 숨겨진 상태는 조건부이며 자연스러운 음성은 스트리밍을 통해 생성됩니다.
액터(이동) 액션 헤드와 표현 헤드로 구성되어 음성과 병행하여 로봇 동작과 표현을 1단계 출력으로 생성합니다. 이는 구현된 시나리오를 위한 WITA-Omni의 핵심 확장입니다.
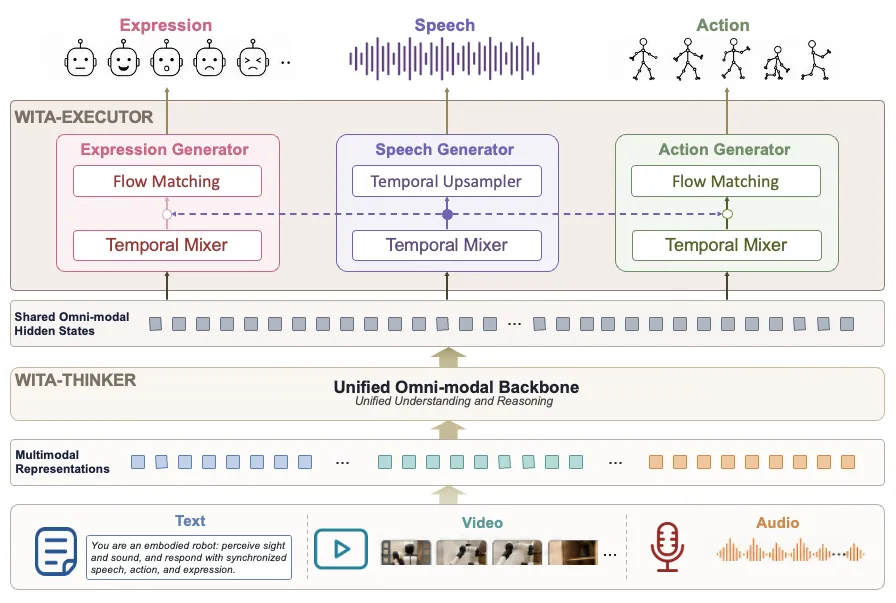
생각하는 사람-말하는 사람-행위자 아키텍처
02/
당신이 앞서 있는 이유:대규모 데이터 교육오버레이 대상 교육 전략
WITA-Omni의 리더십은 모델 규모에만 의존하는 것이 아니라, 구현된 전체 모드 상호 작용을 기반으로 구축된 일련의 계층화된 데이터 시스템과 대상 교육 방법에서 비롯됩니다. 중간 훈련 단계에서 WITA-Omni는 총 수천만 시간의 오픈 소스 및 독점 멀티 모달 데이터를 사용하여 강력한 텍스트 및 시각적 기반을 "오디오 및 비디오를 통해 듣고, 이해하고, 공동 추론을 수행"할 수 있는 풀 모달 모델로 더욱 업그레이드합니다.
또한 공개 오디오 및 비디오 데이터에는 일반적으로 실제 상호 작용에서 차례 전환, 응답 타이밍, 동작 및 표현 정보가 부족하여 엔드투엔드 구현 상호 작용 모델을 직접 교육하기가 어렵습니다. 이를 위해 AGIBOT은 인간 중심적이고 실제 상호 작용 시나리오를 지향하며 소리, 이미지, 언어, 행동 및 표현 간의 자연스러운 시간적 관계를 완전히 유지하는 대규모의 고품질 모든 모드 데이터 세트를 구축했습니다.
수천 시간에 달하는 고품질 데이터에서WITA-Omni는 SFT–OPD–RL 3단계 교육 전략을 추가로 채택합니다.
l SFT 감독 미세 조정은 기본적인 전체 모드 이해, 대화형 의사 결정 및 다중 스트림 생성 기능을 확립하는 데 사용됩니다.
l OPD 동일 전략 증류를 통해 동일한 모델이 동시에 "교사"와 "학생" 역할을 수행할 수 있습니다. 교사 모델은 추가 시간 간격, 대상 객체 등 특권 정보를 획득한 후 고품질 답변을 생성한 후, 그 능력을 다시 특권 정보에 의존하지 않는 학생 모델로 정제합니다. 모델 고유의 표현 스타일을 유지하면서 오디오 및 비디오 맥락에서 추론 능력을 향상시킵니다.
l RL 강화 학습은 Thinker의 대화형 의사 결정 기능을 최적화하는 데 중점을 둡니다. 보상 신호에는 GRPO를 통해 최적화된 모델 전략을 통해 검증 가능한 답변, 시간 간격 매칭, 대상자 선택, 대기 또는 응답 결정, 사전 트리거링 정확도가 포함됩니다.
따라서 모델은 "정확하게 대답"하는 방법을 학습할 뿐만 아니라 응답해야 하는지, 언제 응답해야 하는지, 누구에게 응답해야 하는지 등 실제 시나리오에서 판단하는 방법도 학습합니다.
03/
AGIBOT이 필요한 이유:하나의 세 가지 지능이 계속해서 진화하고 있습니다.실체지능의 새로운 미래를 열다
이번에는 일반 임바디드 AI 트랙에 중점을 둔 회사로 AGIBOT DailyOmni는 많은 주류 Omni 모델을 능가하고 1위에 올랐으며, 이는 물리적 세계에 대한 시청각 타이밍 이해 작업에서 WITA-Omni의 독특한 경쟁력을 입증했습니다.
실현 지능 업계 최초의 엔드투엔드 대규모 로봇 기반 다중 모드 상호 작용 모델인 WITA-Omni의 중요성은 하나의 모델이 더 많은 양식을 지원할 수 있을 뿐만 아니라 로봇이 통합된 인지 상태와 통합된 타임라인에 대한 인식, 의사 결정 및 표현을 완료할 수 있도록 한다는 것입니다. 이는 구현된 상호 작용이 여러 모듈에서 순차적으로 호출되어 지속적으로 인식하고 통일된 판단 및 동기식 표현이 가능한 생성 프로세스로 엔지니어링 파이프라인을 발전시킵니다. 보는 것과 듣는 것이 더 이상 분리되지 않고, 언어와 행동이 더 이상 분리되지 않고, 이해와 반응이 더 이상 독립적인 두 단계가 아니며, "보고, 듣고, 말하고, 움직이는" 것을 연속적인 프로세스로 만들고, 시각, 청각, 언어, 표현 및 신체 움직임의 전체 모드 협업을 열어 로봇이 더 이상 "말하는 도구"가 아니라 다음으로 진화합니다. 실리콘 기반의 존재감과 개성을 지닌 파트너. 이 능력은 실제 시나리오에서 임바디드 AI를 구현하고 생산성을 창출하는 핵심이기도 합니다.
에 의존 WITA-Omni가 구축한 인터랙션 지능형 기반을 통해 Wisdom은 "세 가지 지능을 하나"로 하는 기술 아키텍처를 더욱 통합하고 작업 지능 및 모션 지능와 조정 및 연결하며 "온톨로지-데이터-모델-시나리오"의 4차원 통합 플라이휠 작동을 계속 추진하여 더 많은 비즈니스 시나리오, 공공 서비스, 영화 및 TV 공연 및 기타 광범위한 시나리오를 잠금 해제합니다. 미래에 직면하여 Wisdom은 계속해서 WITA 실리콘 광역학 모델을 반복하고, 임바디드 AI와 인간 의사소통 사이의 거리를 계속 단축하고, 임바디드 AI의 새로운 생산성 시대의 도래를 가속화할 것입니다!